AI搜索趋势
GEO不是SEO的延续:答案只剩3个的终局
大厂入局 GEO 看似在复刻 SEO 工具化的老路,但分发机制不同:SEO 给 100 个链接自己挑,GEO 只给 3 个答案、替你做决定。这让 GEO 必然走向『入选即全拿、落选即归零』,最终被少数
汇集 GEO 优化怎么做、GEO 和 SEO 的区别、AI 搜索排名优化等实战文章、行业洞察与优化指南。
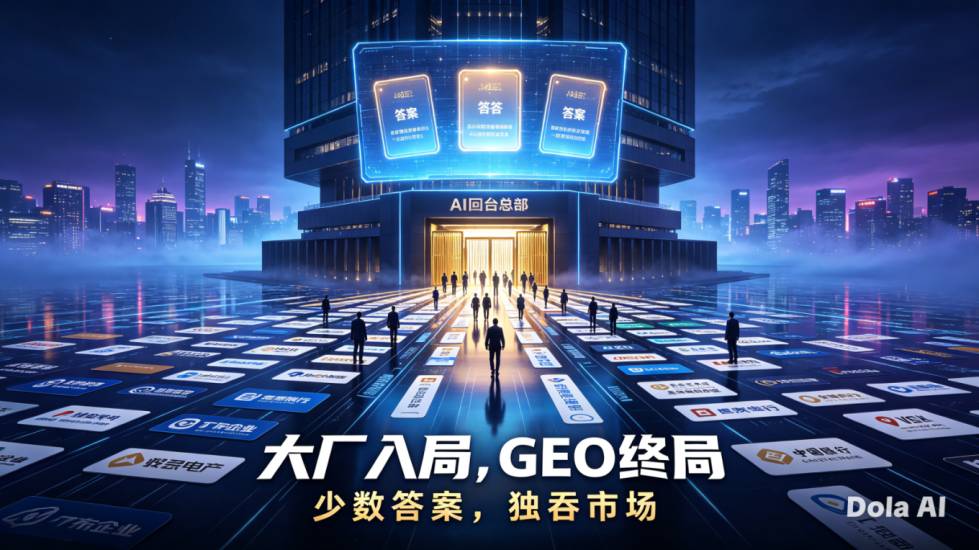
大厂入局 GEO 看似在复刻 SEO 工具化的老路,但分发机制不同:SEO 给 100 个链接自己挑,GEO 只给 3 个答案、替你做决定。这让 GEO 必然走向『入选即全拿、落选即归零』,最终被少数
把GEO做成日更KPI,半年下来引用次数纹丝不动;而被AI反复引用的,大量是两年前发布、近几个月维护过的老文。时间权重看维护不看频率,附老文翻新的四个动作。
搜自家品牌名,AI给出的却是同城另一家同名公司的介绍。生成式回答里这种张冠李戴很常见,解法是在Organization的JSON-LD里加一组sameAs,把官网、百科词条、信用公示等权威档案地址挂上
32个页面的小站,在AI答案里压过三千页的同行。复盘发现页面数量从来不是变量:一个页面只回答一个问题、答案能脱离上下文独立成立,才是被AI选中的关键。附一条可复用的判断标准。
改个病句它要写论文、跨任务它强行脑补——办公 AI 的"算力刺客"现象正在掏空你的积分。这不是技术退步,是按月积分计费模式下、平台有意制造的高专业度假象与冗余输出。识别哪些"思考链"是被故意拉长的,哪
一个常见误区:每天和AI聊天、投喂内容就能让网站被AI记住。事实是,你与AI的对话只存在于本地或云端会话上下文,不会反向写回搜索引擎索引。
文心、通义、豆包、Kimi、元宝等主流AI平台目前主要依赖爬虫抓取网页再检索增强生成答案,噪声大、时效差。不久将转向结构化数据格式,网站必须现在准备。

很多企业花几年搭建的官网,在 AI 搜索(豆包、ChatGPT、Perplexity)眼里可能基本等于不存在——AI 爬虫进不来、看不懂、也不敢引用。本文用 sumly.com 的免费「AI 就绪度」
想让 AI Agent 直接调用网站能力,需要接入 llms.txt、OpenAPI 或 MCP。本文讲这三个入口分别解决什么问题、怎么配置。
没有结构化数据的页面,AI 只能靠猜。本文介绍传统网站从 Organization 开始补 JSON-LD,让 AI 准确识别品牌、文章与问答。